
aocr.orgからのアクセスで起きていること
aocr.orgは実際の流入元とは限らない
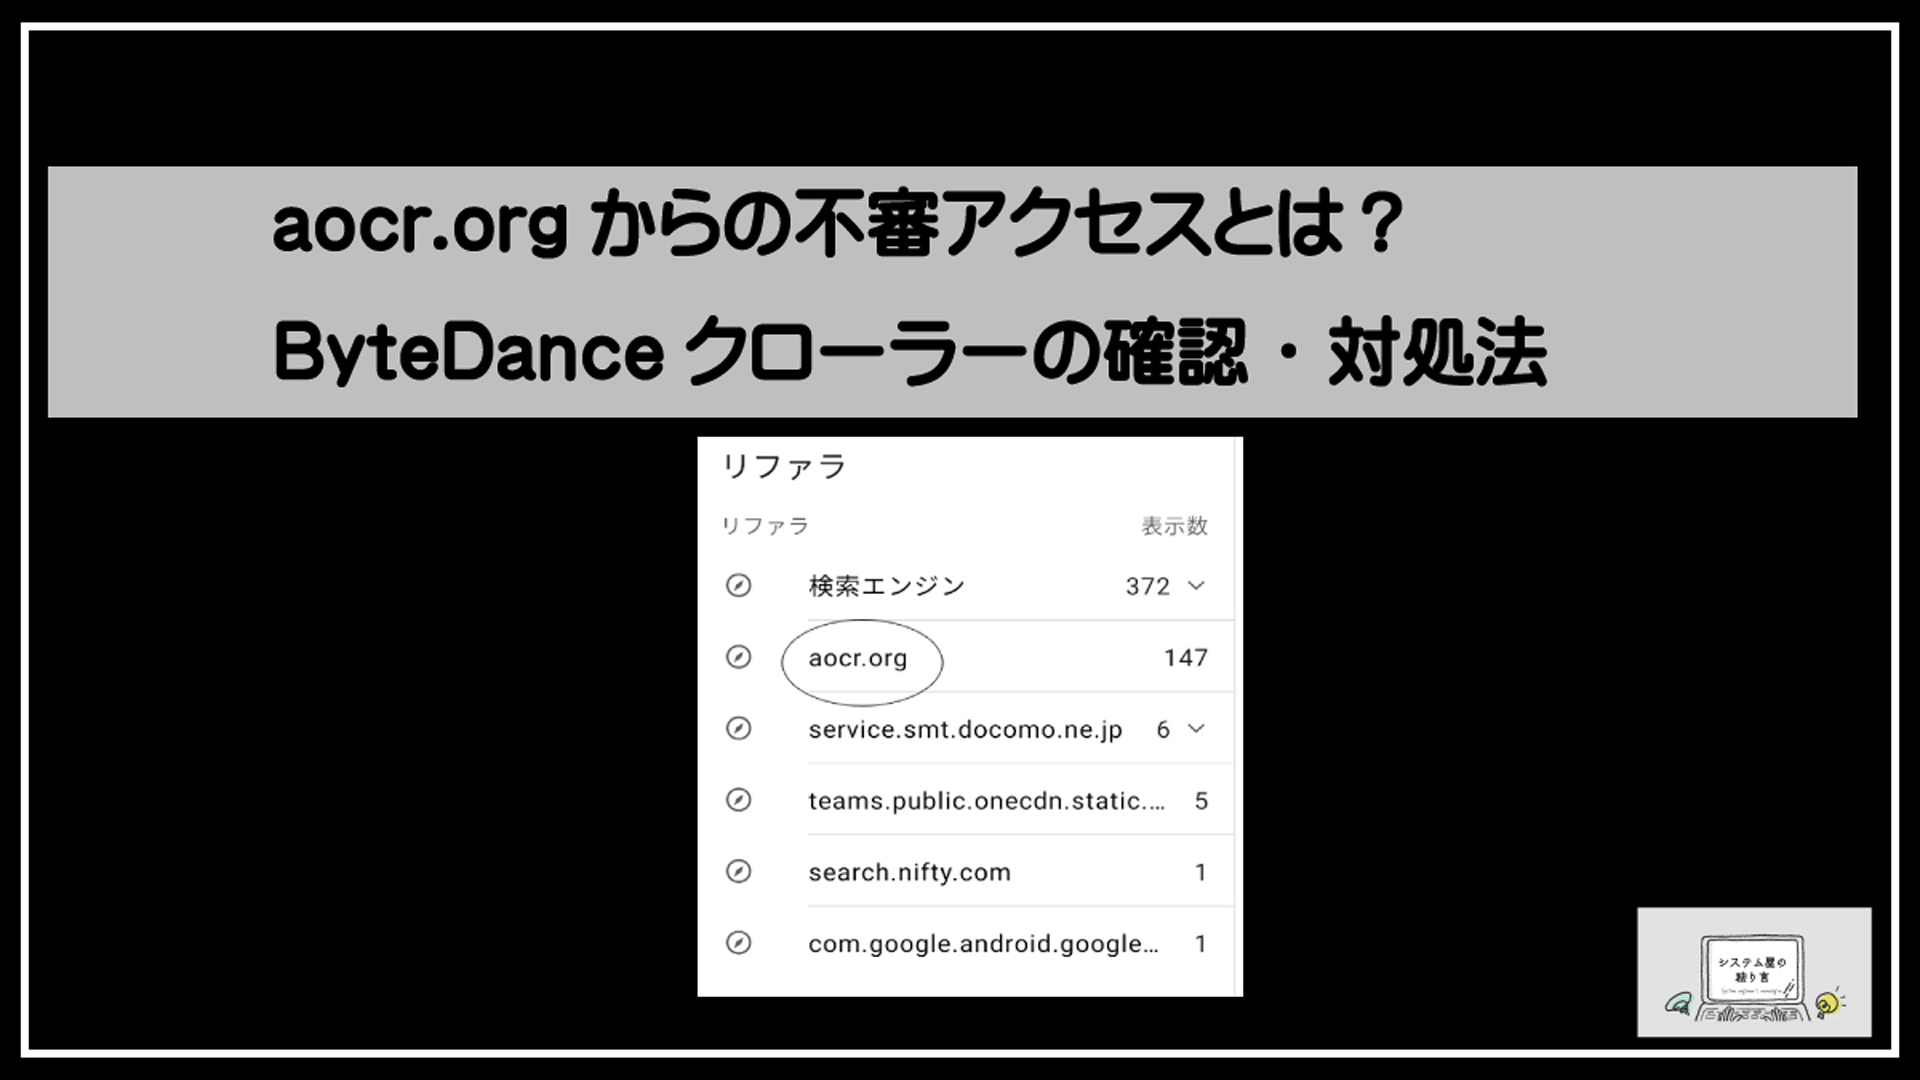
アクセス解析ツールで「aocr.org / referral」や「www.aocr.org」と表示され、急にアクセスが増えたように見えることがあります。しかし、この表示だけで、aocr.orgを経由して実際のユーザーが訪問したとは判断できません。リファラはHTTPリクエストのヘッダー情報であり、アクセス元のプログラムが任意の値を送信できるためです。
aocr.orgは本来、米国の医療教育団体に関連するドメインとして知られています。不審アクセスの文脈では、このドメインの本来の運営者がアクセスしているのではなく、第三者の自動アクセスがリファラとしてドメイン名を表示している可能性を考える必要があります。GA4上で参照元が急増していても、まずはサーバーのアクセスログで実際のリクエストの有無を確認することが重要です。
リファラを偽装した自動アクセスの可能性
リファラ偽装とは、ボットやWeb Crawlerがリクエスト送信時に、実際には訪問していないサイトのURLをRefererヘッダーに設定する行為です。これにより、解析ツールでは特定ドメインからの流入が発生したように記録されます。aocr.orgが参照元として見えるケースも、こうした自動アクセスによるものである可能性があります。
この種のアクセスは、人間の訪問や一般的なリンク経由の流入とは挙動が異なります。短時間に多数のページへアクセスする、同じパターンのURLを連続して取得する、閲覧時間やコンバージョンがほとんど発生しない、といった特徴が見られます。単なる解析上のノイズで済む場合もありますが、アクセス急増によってサーバー負荷や転送量が増える場合は注意が必要です。
なお、リファラを除外する設定はGA4などのレポートを見やすくするうえで有効ですが、実際のリクエストを止める対策ではありません。負荷を抑えたい場合は、User-Agent、IPアドレス、アクセス頻度、対象URLなどをログで確認し、必要に応じてWAFやレート制限で制御します。robots.txtはクローラーへの方針表示として役立ちますが、悪意あるボットやヘッダーを偽装するアクセスを技術的にブロックする機能はありません。
ByteDance系クローラーとの関連が指摘される背景
aocr.orgをリファラとして送る不審なアクセスについては、ByteDance(バイトダンス)のWebクローラーとの関連を指摘する調査報告があります。ByteDanceはTikTok、Doubaoなどのサービスを展開する中国のテクノロジー企業であり、公開情報では「Bytespider」と呼ばれるクローラーの存在が知られています。Bytespiderは、Web上のテキスト、メタデータ、ページ構造などを収集し、検索・インデックス化やAIサービス向けのデータ取得に利用されると説明されています。
アクセスログでは、Bytespiderやspider-feedback@bytedance.comを含むUser-Agentが確認されることがあります。また、aocr.org関連の調査では、通信時のネットワークフィンガープリントやブラウザー内部の情報が、ByteDance系クローラーと整合するとの指摘もあります。一方で、リファラやUser-Agentはいずれも偽装可能であり、aocr.orgからのアクセスをすべてByteDance運用のクローラーだと断定することはできません。
特に、プロキシ経由で接続元IPが変化する場合や、Windows・一般的なChromeブラウザーのように見せかけるヘッダーが使われる場合は、解析が難しくなります。そのため、「ByteDance AI spiderらしい」「TikTok関連のクローラーかもしれない」といった推測だけで即座にブロックするのではなく、User-Agent、IPアドレス、接続元ASN、アクセス間隔、取得対象、HTTPステータスを総合的に確認することが大切です。クローラーアクセスにはコンテンツ発見などのメリットがあり得る一方、過剰なアクセスには負荷や帯域消費というデメリットもあるため、サイト運用方針に沿って許可・制限・遮断を判断します。

不審アクセスがサイトに与える影響
aocr.orgを参照元として表示するアクセスや、ByteDance(バイトダンス)のWebクローラーとみられるアクセスが急増すると、アクセス解析の数値やサーバー運用に影響が出ることがあります。ただし、参照元の表示だけで直ちに攻撃や情報漏えいと判断することは適切ではありません。Web Crawlerによる通常の収集行為、過剰なクロール、リファラ偽装を伴うボットアクセスは、それぞれ分けて評価する必要があります。
アクセス解析で参照元が急増して見える理由
GA4などのアクセス解析サービスでは、リクエストに含まれるRefererヘッダーを基に流入元を分類します。そのため、ボットがRefererにaocr.orgやwww.aocr.orgを設定してアクセスすると、実際にはリンクをクリックした利用者がいなくても「aocr.org / referral」からのアクセスが急増したように表示されます。
これは、aocr.orgの本来の運営者から送客されたことを意味するとは限りません。リファラはクライアント側で比較的容易に指定・偽装できる情報であり、自動アクセスが計測タグを実行した場合には、セッション数、参照元、ページビューなどのレポートを押し上げることがあります。特に、短時間に多数のURLへアクセスされると、通常の集客施策によるアクセス急増と見分けにくくなります。
一方で、ByteDanceのAI spiderとされるBytespiderのようなクローラーは、サイトのコンテンツを収集・解析する目的でアクセスする場合があります。AI学習データの収集、インデックス作成、TikTokを含む関連サービスの技術基盤など、想定される用途はありますが、サイト運営者にとってのメリットが常に明確とは限りません。解析上の数値を正しく読むためには、参照元だけでなく、User-Agent、IPアドレス、閲覧ページ、滞在時間、リクエスト頻度を併せて確認することが重要です。
サーバー負荷と転送量が増えるリスク
クローラーが短時間に大量のページへアクセスすると、WebサーバーのCPU、メモリ、データベース、ネットワーク転送量に負荷がかかります。静的なHTML中心の小規模サイトでは影響が限定的な場合もありますが、動的ページ生成、検索機能、会員認証、外部API連携、画像変換などを含むサービスでは、1件ごとのアクセス処理が重くなりやすいため注意が必要です。
たとえば、Bytespiderと名乗るUser-Agentによるリクエストが、同じ時間帯に数千件単位で発生した事例も報告されています。アクセス先が画像やCSSなどの軽量なアセットだけではなく、個別記事、一覧ページ、検索結果などのページビューに相当するURLへ集中する場合、表示遅延やCPU使用率の上昇につながる可能性があります。従量課金制のクラウドサービスやCDNを利用している場合は、転送量・リクエスト数の増加がコスト増加に直結する点もデメリットです。
ただし、ByteDance(バイトダンス)のWebクローラーと判定できたからといって、すべてを即時にブロックすべきとは限りません。robots.txtを尊重する正規クローラーであり、サイトの公開方針や外部サービスでの露出に合致するなら、アクセスを許可する選択肢もあります。反対に、クロール頻度が過剰でサービス品質に支障がある場合は、WAF、CDN、レート制限などで段階的に制御する判断が必要です。
セキュリティ侵害とクローラーアクセスの違い
不審なクローラーアクセスと、サイトが不正侵入を受けたことは同義ではありません。クローラーは基本的に、外部から閲覧可能なページへHTTPリクエストを送る仕組みです。公開済みのコンテンツを取得しているだけであれば、それ自体は管理画面への侵入、データ改ざん、個人情報の窃取を示すものではありません。
一方で、通常のWeb Crawlerの挙動から外れ、ログイン画面、管理画面、APIエンドポイント、設定ファイル、バックアップファイルなどを繰り返し探索している場合は、脆弱性調査や攻撃の前段階である可能性があります。また、極端に高い頻度でリクエストを送る、異常なパラメータを付ける、存在しないURLを大量に試す、403・404・500エラーが急増するといった兆候があれば、単純なコンテンツ収集とは分けて調査すべきです。
aocr.orgを含むリファラ表示や、BytespiderというUser-Agentだけでは、アクセスの安全性や運用主体を断定できません。User-AgentやRefererは偽装されることがあるためです。アクセスログを基に、対象URL、HTTPステータス、通信量、アクセス間隔、接続元IP、ASN、robots.txtへの反応を確認し、通常のクローリングなのか、負荷を与えるボットなのか、セキュリティ対策が必要なアクセスなのかを切り分けることが大切です。
アクセスログで確認すべき項目
aocr.orgからのアクセス急増が解析ツールで見つかった場合は、リファラ表示だけで判断せず、WebサーバーやCDN、WAFのアクセスログを確認することが重要です。User-Agent、接続元IPアドレス、アクセス頻度、要求されたURL、HTTPステータスを組み合わせて見ることで、ByteDance(バイトダンス)のWebクローラーとされるBytespiderなのか、単なるリファラ偽装なのかを切り分けやすくなります。
User-AgentからBytespider関連の識別子を確認する
最初に確認したいのは、リクエストヘッダーに含まれるUser-Agentです。ByteDanceのWeb Crawlerとして知られるBytespiderでは、User-Agent内にBytespiderやspider-feedback@bytedance.comといった識別子が含まれる場合があります。たとえば、Mozilla/5.0 (compatible; Bytespider; spider-feedback@bytedance.com)のような記録があれば、Bytespider関連のアクセスである可能性を検討できます。
ただし、User-Agentは送信元が任意に設定できる情報です。そのため、「Bytespider」と書かれているだけでByteDanceやTikTokに関係する正規のクローラーだと断定してはいけません。逆に、一般的なChromeやSafariを装い、識別子を出さないボットもあります。User-Agentは有力な手掛かりではあるものの、後述するIPアドレスやアクセスパターンと併せて評価する必要があります。
IPアドレス・逆引き・接続元ASNを調べる
次に、アクセス元IPアドレスを確認します。同じIPから短時間に大量のリクエストが発生している場合は、クローラーや自動化ツールによるアクセスの可能性が高まります。一方で、aocr.org クローラーに関する報告では、実際の接続ごとに異なるプロキシIPを使うように見えるケースも指摘されています。そのため、単一IPだけを追うのではなく、IP帯域、国・地域、接続元事業者を一定期間で集計することが大切です。
必要に応じて、IPアドレスの逆引きDNSやASN(自律システム番号)も調べます。逆引き結果やASNからクラウド事業者、通信事業者、データセンターなどを把握できれば、アクセス元の性質を判断する補助材料になります。ただし、プロキシやVPN、CDNを経由したアクセスでは、表示されるIPが実際のクローラー運用元を示すとは限りません。逆引き情報がない、あるいは一般的なクラウド事業者のIPであることだけを理由に、悪意あるアクセスと結論付けるのは避けましょう。
アクセス頻度・対象URL・HTTPステータスを分析する
クローラー対策では、どのくらいの頻度で、どのページに、どのような結果でアクセスしているかを確認します。たとえば数秒間に数十件以上のアクセスが続く、サイト内の多数のページを規則的に巡回する、検索結果URLやパラメータ付きURLを繰り返し取得するといった挙動は、サイトの負荷や転送量を増やす原因になります。
対象URLの傾向も重要です。公開記事だけをクロールしているのか、画像・PDF・動画など容量の大きいファイルまで取得しているのか、ログイン画面や管理画面、存在しないURLにアクセスしているのかで、対応方針は変わります。また、HTTPステータスでは、200が多い場合は実際にコンテンツが取得されていること、301や302が多い場合はリダイレクトを繰り返し追っていること、404が多い場合はURL探索やリンク切れの巡回が疑われることを示します。
サーバー負荷が問題になっている場合は、リクエスト数だけでなく、レスポンスサイズ、処理時間、CPU使用率、帯域幅との時間的な一致も確認してください。ByteDance AI spiderを含むAIクローラーは、通常の検索エンジン向けクローラーと比較してアクセス量が多くなることがあります。サイト運営上のメリット・デメリットを判断するには、「どのサービスに役立つ可能性があるか」よりも先に、自サイトの表示速度や安定運用に影響しているかを数値で把握することが必要です。
リファラだけで判定しないための注意点
GA4などでaocr.org / referralと表示されていても、それがaocr.orgを訪れた利用者の流入を意味するとは限りません。HTTPリファラはリクエスト送信側で設定できるため、ボットが偽のリファラを付与すれば、アクセス解析上は参照元からの訪問のように見えます。aocr.orgは本来のドメイン運営者とは無関係に、リファラとして悪用・偽装されている可能性も考慮すべきです。
特に、参照元の急増と同時にエンゲージメント時間が極端に短い、閲覧ページ数が不自然、コンバージョンが発生しない、同一時刻に大量のセッションが集中するといった状況では、自動アクセスを疑います。ただし、GA4の計測タグを実行しない単純なクローラーは解析画面に現れないこともあります。したがって、アクセス解析は傾向把握に使い、最終判断はサーバーログやWAFログを基に行うことが安全です。
なお、robots.txtはWeb Crawlerに対してクロール方針を伝えるための仕組みであり、アクセス元の本人確認や強制的なブロックを行う機能ではありません。リファラやUser-Agentの表示だけで即座に遮断するのではなく、ログで挙動を確認したうえで、robots.txt、レート制限、WAFによる制御、IPブロックを使い分けることが重要です。
ByteDanceクローラーかを判断する手順
aocr.orgからのアクセス急増が見られた場合は、アクセス解析のリファラ表示だけでByteDance(バイトダンス)のWebクローラーと断定しないことが重要です。aocr.orgは本来のアクセス元を示すものではなく、リファラを偽装したヘッダーとして使われている可能性があります。サーバーのアクセスログを基に、User-Agent、接続元IPアドレス、アクセス間隔、リクエスト対象などを組み合わせて確認します。
なお、BytespiderはByteDanceのサービスやAI関連のデータ収集に利用されるとされるWeb Crawlerです。TikTokを運営するByteDanceに関連するクローラーとして知られていますが、名称やヘッダーは偽装できるため、単一の情報だけで正規のByteDance AI spiderと判断することはできません。
BytespiderのUser-Agentを手掛かりにする
最初に確認したいのは、Webサーバーのログに記録されたUser-Agentです。Bytespiderを名乗るアクセスでは、User-Agent内にBytespiderやspider-feedback@bytedance.comといった識別子が含まれることがあります。例えば、Mozilla/5.0 (compatible; Bytespider; spider-feedback@bytedance.com)のような形式です。
ログを集計し、Bytespiderを含むUser-Agentの件数、アクセス時間帯、対象URL、レスポンスサイズを確認してください。短時間に多数のHTMLページへ連続アクセスしている場合、通常の閲覧者ではなくクローラーによる巡回である可能性が高まります。画像・CSS・JavaScriptなどのアセットをほとんど取得せず、本文ページだけを大量に取得する挙動も判断材料になります。
ただし、User-Agentはリクエスト側が任意に設定できるヘッダーです。Bytespiderと表示されていても、それだけでは正規のByteDanceクローラーと証明できません。逆に、aocr.orgがリファラに表示されていても、User-AgentにBytespiderの識別子がなければ、別のボットまたは単なるリファラスパムである可能性を考慮します。
プロキシ経由や偽装ヘッダーを想定する
aocr.org クローラーに関する報告では、中国国内のサーバーから動作しつつ、ページごとに異なる米国のプロキシIPアドレスを利用するように見える挙動が指摘されています。このようなアクセスでは、IPアドレスの国だけを見て接続元や運営主体を判断することはできません。米国IPからのアクセスであっても、実際の処理基盤が米国外にある場合があります。
また、Referer、User-Agent、X-Forwarded-ForなどのHTTPヘッダーは偽装されることがあります。特に、GA4でaocr.org / referralが増えている場合、解析画面だけでは、実際にサイトへアクセスされたのか、計測用のリクエストだけが送られたのかを切り分けにくいことがあります。必ずWebサーバー、CDN、WAFのログにも同じ時刻・URLのリクエストが存在するかを照合してください。
確認時は、IPアドレスの逆引き結果、ASN、TLSフィンガープリント、HTTPヘッダーの一貫性など、複数の情報を総合します。ただし、ネットワークフィンガープリントやブラウザー内部の挙動まで検証するには専門的な環境が必要です。通常のサイト運用では、偽装の可能性を前提に、アクセス頻度とサーバー負荷を軸として制御方針を決めることが現実的です。
正規クローラーと悪意あるボットを切り分ける
ByteDanceのWebクローラーである可能性があっても、直ちにセキュリティ侵害や攻撃と判断する必要はありません。コンテンツの収集・インデックス化を目的とするクローラーであれば、サイトの公開ページをGETリクエストで取得しているだけの場合があります。一方で、アクセス急増によってCPU使用率、転送量、データベース負荷が高まり、閲覧者の表示速度に影響するなら、運用上は対策が必要です。
正規クローラーかどうかを判断する際は、robots.txtの方針を尊重しているか、アクセス頻度が過剰ではないか、存在しないURLや管理画面、検索フォーム、ログイン画面を繰り返し試していないかを確認します。robots.txtに従い、公開コンテンツを一定間隔で取得するだけなら、クローラーとしての性質が強いと考えられます。反対に、robots.txtを無視する、毎秒多数のリクエストを送る、404や403を大量に発生させる、POSTリクエストや不自然なパラメータを繰り返す場合は、悪意あるボットとして扱うべきです。
アクセスを許可するメリットは、ByteDance系サービスや関連するAI・検索サービスでコンテンツが参照される可能性がある点です。ただし、その効果や掲載範囲は明確ではありません。デメリットは、サーバー負荷、帯域消費、アクセス解析のノイズ増加です。サイトの目的、サーバー性能、コンテンツの公開方針を踏まえ、robots.txtでの意思表示、WAFによる制限、レート制限、必要に応じたブロックを選択してください。
不審なクローラーへの基本的な対処法
aocr.orgをリファラとして表示するアクセスや、ByteDance(バイトダンス)のWebクローラーとみられるアクセスが急増した場合は、リファラ名だけで一律に遮断するのではなく、ログを確認したうえで段階的に対処することが重要です。Web Crawlerには検索・情報収集などの用途がある一方、短時間の大量アクセスはサーバー負荷や転送量の増加につながります。robots.txt、WAF、レート制限、IP遮断を目的に応じて使い分けましょう。
robots.txtでクロール方針を明示する
まずはrobots.txtを設置・見直し、サイトとしてどのクローラーにどの範囲のクロールを許可するかを明示します。Bytespiderを含むAI spiderによる収集を望まない場合は、User-agentを指定して拒否する方法があります。
たとえば、Bytespiderを対象にサイト全体のクロールを拒否する場合、robots.txtには「User-agent: Bytespider」「Disallow: /」という方針を記載します。ただし、robots.txtは法的・技術的にアクセスを強制停止させる仕組みではありません。正規のクローラーが方針を尊重することを期待するためのルールであり、User-Agentを偽装するボットや、robots.txtを無視するアクセスには効果がありません。
また、ByteDanceのサービスやTikTok経由での露出に期待するサイトでは、全面拒否が必ずしも最適とは限りません。公開コンテンツの収集を許可するメリットと、AI学習用途を含むクローラーアクセスによる負荷・コンテンツ利用のデメリットを分けて検討することが大切です。管理画面、検索結果ページ、内部API、会員限定ページなどは、クローラーの種類を問わずクロール対象から除外する方針が基本となります。
WAFでUser-Agent・アクセス頻度を制御する
robots.txtだけでは抑制できない場合は、WAF(Web Application Firewall)で制御します。WAFでは、User-Agentに「Bytespider」が含まれるアクセスを対象に、ブロック、チャレンジ、監視などのルールを設定できます。aocr.orgをリファラに含む通信だけを根拠に遮断する方法もありますが、リファラは簡単に偽装できるため、単独の判定条件にすることはおすすめできません。
実運用では、User-Agent、リクエスト回数、アクセス先URL、HTTPメソッド、国・ASN、既知の不正シグネチャなど、複数の条件を組み合わせて判定します。たとえば、Bytespiderを名乗りながら短時間に多数のページを巡回し、同じURLや存在しないURLへ繰り返しアクセスする場合は、制限対象とする合理性があります。
一方で、User-Agentは偽装可能です。Bytespiderという文字列だけをブロックしても、別のブラウザー名を名乗る自動アクセスは残ります。そのためWAFでは、特定の名称によるブロックを入口としつつ、異常なアクセス頻度やアクセスパターンを検知するボット対策機能も併用すると効果的です。
レート制限で過剰なリクエストを抑制する
アクセス急増による表示遅延やサーバー高負荷を防ぐには、レート制限が有効です。レート制限とは、一定時間内に許可するリクエスト数を制限する仕組みです。完全にブロックするのではなく、過剰なアクセスだけを抑えられるため、通常の利用者や必要なクローラーへの影響を抑えやすい点がメリットです。
たとえば、同一IPアドレス、同一User-Agent、同一セッションなどを単位として、1分間あたりのアクセス数に上限を設けます。ページ閲覧のようなGETリクエストには比較的緩やかな上限を設定し、検索フォーム、ログイン、問い合わせ、APIなどの負荷や悪用リスクが高いURLには、より厳しい上限を設定する方法が実践的です。
ただし、aocr.org関連のアクセスで指摘されているように、プロキシ経由でIPアドレスが変わるケースでは、IP単位の制限だけでは十分に機能しないことがあります。この場合は、IPに加えてUser-Agent、URLごとのアクセス回数、短時間での連続巡回、異常なHTTPヘッダーといった条件も評価します。CDNやWAFのレート制限機能を使えば、Webサーバーへ到達する前に過剰な通信を抑制できます。
設定値は、サイトの通常時のアクセス状況を計測してから決める必要があります。上限を厳しくしすぎると、企業内ネットワークや携帯キャリア回線など、複数ユーザーが同じIPアドレスを共有する環境で正規利用者まで制限されるおそれがあります。導入直後はログ記録や警告のみで挙動を確認し、問題がなければ段階的に拒否へ移行すると安全です。
特定IPの遮断は影響を確認してから行う
明らかに過剰なアクセスを続けるIPアドレスが確認できた場合は、ファイアウォール、WAF、Webサーバー設定などで個別に遮断できます。短期間に数千件規模のリクエストを送るIPや、脆弱性探索、管理画面への総当たり、存在しないURLへの連続アクセスなど、悪意が疑われる挙動がある場合には有効な対処です。
ただし、特定IPのブロックにはデメリットもあります。ByteDance AI spiderなどのクローラーがクラウドやプロキシを利用している場合、IPを1件ずつ遮断しても送信元が変わり、いたちごっこになりかねません。また、クラウド事業者や通信事業者の広いIPレンジをまとめて遮断すると、正規ユーザー、提携サービス、検索クローラーなどまでアクセスできなくなる可能性があります。
IP遮断を行う前には、対象IPのアクセス日時、User-Agent、参照URL、要求されたパス、リクエスト数、HTTPステータス、転送量を記録しましょう。遮断後も、サーバー負荷が下がったか、エラー率が増えていないか、検索流入や外部サービス連携に影響が出ていないかを確認します。恒久的なブロックではなく、まずは期限付きの遮断やレート制限を適用し、状況に応じて見直す運用が適しています。
アクセス解析と運用での再発防止策
解析ツールで不要なリファラを除外する
aocr.org / referralのような不審な参照元がGA4などのアクセス解析に表示されると、実際の集客状況やコンバージョン率を正しく判断しにくくなります。解析ツールでは、不要なリファラを除外する設定や、探索レポートでボット由来のセッションを分けて確認する運用を行うとよいでしょう。
ただし、解析ツール上でリファラを除外しても、Webサーバーへのアクセス自体を止める効果はありません。これはレポートのノイズを減らすための対策です。aocr.orgを含む偽装リファラによるアクセス急増については、アクセスログ、WAF、レート制限などのサーバー側対策と分けて考えることが重要です。
ログ監視と負荷アラートを設定する
ByteDance(バイトダンス)のWebクローラーや、User-AgentにBytespiderを含むAI spiderによるアクセスは、短時間に集中することがあります。通常時のリクエスト数、転送量、CPU使用率、メモリ使用率、応答時間を記録し、普段の水準を把握しておきましょう。
そのうえで、特定時間あたりのアクセス数や同一IP・同一User-Agentからのリクエスト数、4xx・5xxエラー率、転送量が一定値を超えた場合に通知するアラートを設定します。Webサービスの表示遅延が起きる前に、クローラーの集中アクセスや異常なボットトラフィックを把握しやすくなります。IPアドレスが頻繁に変わるケースもあるため、IPだけでなくURL、アクセス頻度、User-Agent、ASNなどを組み合わせて監視することが有効です。
ブロック後に検索・表示への影響を検証する
Bytespiderなどをブロックする場合、robots.txt、WAF、CDN、Webサーバー設定のどこで制御したのかを明確にし、導入後の影響を確認します。特にWAFで広範囲の条件を設定すると、一般ユーザーや正規のWeb Crawlerまで誤って遮断するおそれがあります。
ブロック後は、CPU負荷、帯域使用量、ページ表示速度、エラー率、キャッシュヒット率を比較し、対策によるメリットを数値で確認してください。また、Google Search Consoleなどで検索クローラーのクロールエラーやインデックス状況に変化がないかも確認します。ByteDanceのサービスやTikTok関連の露出を重視するサイトでは、クロール拒否によるデメリットも考慮し、サイトの目的に合った判断を行う必要があります。
対応記録を残しルールを定期的に見直す
不審アクセスに対応した際は、検知日時、対象となったURL、User-Agent、IPアドレス、リファラ、実施したブロック内容、負荷の変化を記録しておきます。aocr.orgのようにリファラが偽装される事例では、参照元表示だけで遮断の根拠とせず、実際のアクセスログに基づいて判断した経緯を残すことが大切です。
クローラーの仕様やアクセス元のネットワーク、User-Agentは変化する可能性があります。一度設定したrobots.txtやWAFルールを放置せず、定期的にログを確認して、過剰なブロックや不要になった例外設定を見直してください。許可・制限・遮断の基準を文書化しておけば、担当者が変わった場合でも一貫した運用につながります。
aocr.orgからの不審アクセスに落ち着いて対応するポイント
aocr.org / referral としてアクセス解析に表示される急増は、突然の不正侵入やサイト改ざんを意味するとは限りません。報告されている事例では、リファラを偽装した自動アクセスや、ByteDance(バイトダンス)のWebクローラーであるBytespiderと共通する特徴を持つアクセスが指摘されています。まずは解析画面の数値だけで判断せず、Webサーバーのアクセスログを根拠に、影響の有無と必要な対策を切り分けることが重要です。
リファラ表示だけで被害と判断しない
GA4などで
また、クローラーアクセスは、脆弱性を悪用する攻撃やアカウントへの不正ログインとは性質が異なります。ページを短時間に大量取得されることでサーバー負荷や転送量が増えるデメリットはありますが、ただちに情報漏えい・改ざんが発生したとはいえません。管理画面へのログイン試行、POSTリクエストの急増、見覚えのないファイル変更、エラーログの異常などがないかを確認し、クローリングと侵害の兆候を分けて評価してください。
ログに基づいて許可・制限・遮断を選ぶ
対策を選ぶ際は、アクセスログでUser-Agent、IPアドレス、アクセス頻度、対象URL、HTTPステータス、転送量を確認します。User-Agentに「Bytespider」や「spider-feedback@bytedance.com」が含まれていれば、ByteDance AI spiderに関連するアクセスの可能性を調べる手掛かりになります。ただし、User-Agentは偽装も可能なため、名称だけを根拠にブロックするのではなく、リクエストの挙動も合わせて確認する必要があります。
負荷が軽微で、サイトの公開方針とも矛盾しない場合は、監視を継続しながら許可する選択肢があります。一方で、同一URLへの連続アクセス、動的ページの大量巡回、CPU使用率や帯域の上昇、一般ユーザーの表示遅延が見られる場合は、レート制限やWAFによる制御が有効です。明確に過剰なアクセスが継続し、サービス運営へ支障が出る場合に限って、User-Agent・IP・ASN・アクセスパターンなど複数の条件を組み合わせてブロックを検討します。
robots.txtには、Webクローラーに対するクロール方針を記載できます。たとえば、Bytespiderを対象にクロールを拒否する方針は示せますが、robots.txtは技術的なアクセス遮断機能ではありません。robots.txtを無視するボットや、識別情報を偽装するアクセスに対しては、WAF、CDN、Webサーバーのアクセス制御、レート制限などを併用してください。
サイトの目的と負荷に合う対策を継続する
ByteDanceのWebクローラーへの対応に唯一の正解はありません。TikTokやByteDanceのサービス上での露出、AI検索・AIサービスにおける参照可能性を重視するサイトであれば、クローラーアクセスには一定のメリットがある可能性があります。一方、会員制サービス、ECサイト、API、動的コンテンツが多いサイトでは、過剰なクロールが応答速度やインフラ費用へ与えるデメリットを重視すべきです。
特にアクセス急増が起きたときは、一律に中国からのアクセスや広範なIP帯域を遮断すると、正規ユーザー、提携先サービス、他の正常なクローラーまで影響を受けるおそれがあります。まずは負荷の発生時間、頻度、URLの傾向を可視化し、必要最小限のルールから適用することが大切です。ブロック後も、サーバー負荷、エラー率、検索流入、ページ表示速度を確認し、効果と副作用を検証します。
aocr.org クローラーと見られるアクセスは、リファラ偽装やプロキシ利用が指摘されているため、単発の設定で完全に解決できるとは限りません。ログ監視、負荷アラート、WAFルール、robots.txtの内容を定期的に見直し、実際のアクセス状況に応じて許可・制限・遮断を調整し続けることが、安定したWebサービス運用につながります。
省スペースPC GEEKOMをお探しの方はこちら
※こちらから購入すると支払時に3,500円引き
※支払時に3,500円の値引きがない場合はクーポンコードを入力してください。
クーポンコード
TAKESHI
TAKESHI
購入はこちらをクリック↓↓↓
GEEKOM PC購入時の注意点
電源コードがアース付きの3ピンとなってます。3ピン→2ピンの変換をお持ち出ない方は購入を Officeもついていません。必要な方はこちらより購入を

Office(Word Execl等)が必要な方はこちら
Word Execl Outlook

Word Execl Outlook PowerPoint

-

-
高性能ミニPC Amazonでの評判がすごく良いGEEKOM OS搭載ですぐに使用可能
台湾の新興PCメーカーGEEKOMギコム高性能の小型PCを専門的に製造、販売 当ブログ購読者限定3,500円OFFのクーポンコード公開 省スペースデスクトップで高性能 CPUもINTELとAMD両方ともラインナップ やめとけというかたもいるが評判はすこぶる良い
続きを見る
#aocr.org #不審アクセス #ByteDance #クローラー #確認 #対処法